AI 能帮你写 BIM 信息交付规范了吗?先别急着把活儿全交给它。2026年11月4日,日本 ONESTRUCTION 公布,Ishigaki-IDS-Bench 论文获 CIKM 2026 Resource Track(资源赛道)收录——这是第一个专门评测 AI 能否把 BIM 信息要求转换成 IDS 的基准。同一天,同一团队的 Ishigaki-BIM(β)开启测试招募,但这次的学术成果讲的不是新产品,而是一把”尺子”:以后谁说自家 AI 会写 IDS,都得先过这把尺子的量。
第一批实测结果并不乐观:10 种大语言模型里,最高 F1 为 65.6%,最高内容检查通过率只有 33.1%。AI 写出来的 IDS 看着像模像样,真要拿去交付,三分之二以上还过不了内容这一关。本文把这项研究讲清楚:基准是怎么建的、两阶段核查查什么、对国内 BIM 从业者意味着什么。
一句话概括:日本 ONESTRUCTION 与 AWS Generative AI Innovation Center 合作,用 6 名专家编写的 83 个实务场景(日英双语 166 个示例)建成评测基准,论文获 CIKM 2026 Resource Track 收录;对 10 种大模型实测,最高 F1 为 65.6%,最高内容检查通过率 33.1%。CIKM 2026 大会于 2026年11月7日至11日在罗马举行,企业安排研究人员作口头报告。论文、数据集及评测代码已公开。
IDS 是什么?为什么它值得一个评测基准
做 BIM 的人都知道,模型建得再漂亮,信息交不齐、交不对,等于白建。IDS(信息交付规范)就是解决这个问题的工具:它把”这个项目要交付哪些信息”组织成机器可检查的形式,让软件能自动核对模型里有没有按要求填信息。
但写 IDS 门槛不低,要求写作者同时理解 BIM、IFC 词汇及验证规则,把一句句自然语言需求翻译成严谨的规范条目。懂业务的人不一定会写规范,会写规范的人又未必熟悉每个项目的业务细节——这正是 AI 被寄予厚望的地方。
问题在于,过去没有一把公认的尺子衡量 AI 这活儿干得怎么样。没有评测基准,所谓”AI 会写 IDS”只能停留在演示层面,无法比较、无法复现、更无法作为交付依据。Ishigaki-IDS-Bench 补的就是这个缺口。
Ishigaki-IDS-Bench 是怎么建的
评测基准靠不靠谱,首先看题库是怎么来的。这项研究的题库不是网上随便抓的语料,而是由 6 名 BIM 与 IDS 专家编写的 83 个实务场景,形成日语和英语双语共 166 个示例,并配套参考 IDS 文件。每个测试用例都有专家写好的”标准答案”,供 AI 生成结果逐项比对。
- 83 个实务场景:由 6 名 BIM 与 IDS 专家编写,贴近真实工作而非教科书例题。
- 双语 166 个示例:日语和英语各一份,同一场景两种语言对照,方便国际研究者复用和对比。
- 配套参考 IDS 文件:每个示例都有专家给出的参考 IDS,作为内容比对的依据,避免评分争议。
- 论文、数据集及评测代码已公开:其他团队可以直接复现评测结果,也可以在此基础上继续改进。
值得注意的是,这项研究与同一团队的 Ishigaki-BIM 属于同一研究线。Ishigaki-BIM(β)于 11月4日开启测试招募,主打自然语言或图纸生成 BIM 模型;而 Ishigaki-IDS-Bench 解决的是另一端的问题:模型建出来之后,信息要求能不能被机器检查、被规范表达。一个管”生成模型”,一个管”校验信息”,两者互补。但不要把这次的学术收录写成”新产品发布”——它是一项评测研究,不是产品上线。
两阶段核查:格式过关不等于内容靠谱
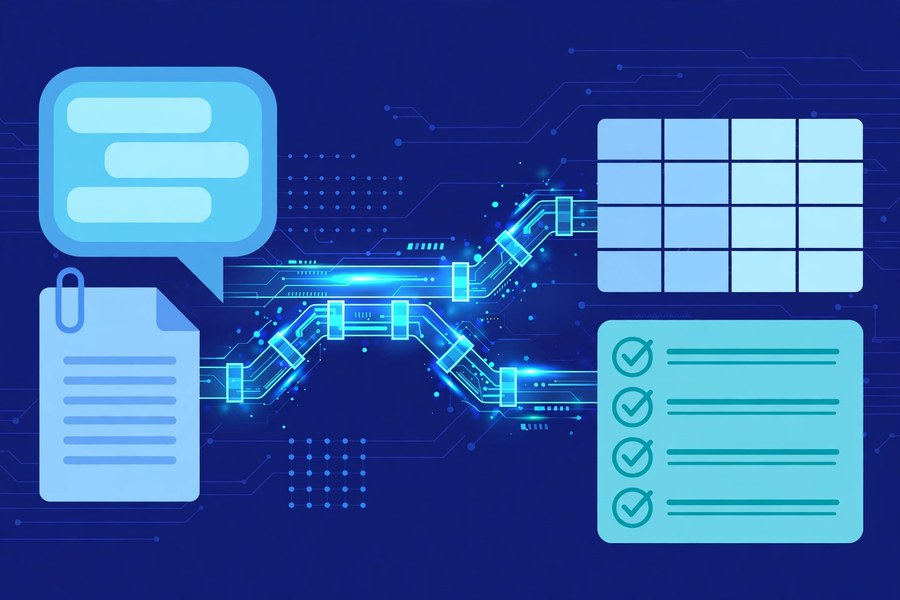
Ishigaki-IDS-Bench 的评测分两个阶段,这个设计本身就是它最值得借鉴的地方。
第一阶段:格式符合性检查
用 buildingSMART 的 IDS Audit Tool 检查生成的 IDS 规范格式是否符合要求。这一关只看”写得规不规范”:文件结构、字段、语法有没有问题,工具自动判定,客观、快速。
第二阶段:内容比对检查
把 AI 生成的内容与专家参考答案逐项比对,查”写得对不对”:每一条信息要求有没有被正确理解、有没有漏项、有没有转译错。这一关才是真正的难点,也是人工复核成本最高的地方。
两阶段分开查的意义在于:一个 IDS 文件完全可能格式满分、内容不及格。格式是机器能自动验证的,内容却涉及对业务需求的理解。很多 AI 生成物的问题恰恰藏在这里——表面工整,细看跑偏。把两关拆开,才能看清 AI 到底卡在哪一步。
10 种大模型实测:数字说明了什么
研究团队用这套基准对 10 种大语言模型做了评测,结果如下:
| 评价维度 | 最高成绩 | 说明 |
|---|---|---|
| F1 | 65.6% | 综合反映生成内容与专家参考答案的吻合程度 |
| 内容检查通过率 | 33.1% | 生成内容逐项比对后通过内容检查的比例 |
两项成绩分属不同评价维度,不能直接混为一谈。但它们共同指向一个结论:格式过关不等于内容靠谱。F1 最高 65.6%,意味着即使表现最好的模型,生成内容与专家答案之间仍有不小的差距;而内容检查通过率最高只有 33.1%,大约三分之二的生成结果在内容上通不过逐项比对。
这个数字对从业者是一个清醒剂:AI 写 IDS 目前更适合当”初稿助手”,而不是”交付工具”。它能帮你把自然语言需求快速转成一份结构化的 IDS 草稿,省掉从零起草的时间;但草稿里的每一条,都需要懂业务、懂 IFC 词汇和验证规则的人逐项复核,才能用于实际交付。跳过复核直接交付,风险不在格式上,而在内容里那些看起来正确、实际跑偏的条目上。
这对国内 BIM 从业者意味着什么
1. 先有”尺子”,才有”进步”
在 Ishigaki-IDS-Bench 之前,讨论 AI 写 IDS 的能力多停留在个案和演示。有了公开的基准和代码,不同模型、不同方法第一次有了可比较、可复现的成绩。后续任何声称”AI 写 IDS 更准了”的研究,都可以在同一套题上验证。这种可比较性,是技术从演示走向工程应用的前提。
2. 明确了 AI 的能力边界:草稿可以,交付还不行
33.1% 的内容检查通过率是一个很诚实的数字。它告诉项目团队:可以把 AI 引入 IDS 编写流程,但要把人工复核设计进流程里,而不是指望 AI 一次到位。合理的工作流是”AI 起草 + 专家复核 + 工具校验”,而不是”AI 生成 + 直接交付”。理解这个边界,比盲目追捧或全盘否定都重要。
3. 与日本 BIM 政策环境同频
日本方面对 BIM 的推进正在加速,相关强制要求也在讨论和落地之中,信息交付的规范化需求只会越来越强。国内项目同样面临信息交付标准化的压力,提前理解 IDS 和 AI 生成 IDS 的能力边界,有助于少走弯路。相关阅读:日本BIM强制令相关解读、一句话生成BIM模型?日本AI智能体Ishigaki-BIM开启测试、IFC与glTF相关文章。
AI 写 IDS:现在能怎么用、不能怎么用
- 能用:用 AI 把自然语言信息要求快速转成 IDS 初稿,节省从零起草的时间;用 IDS Audit Tool 先做格式自查,快速发现结构问题。
- 能用:把基准的思路借用到自己的项目里——先定”参考答案”,再让 AI 生成,最后逐项比对,而不是只看生成结果”像不像”。
- 不能:把 AI 生成的 IDS 未经复核直接用于交付,内容检查通过率最高只有 33.1%;也不能只看格式合规就放行,两阶段都要查。
- 值得跟进:论文、数据集及评测代码已公开,关注后续研究在同一基准上的成绩变化,比看单次发布更有参考价值。
常见问题 FAQ
1. Ishigaki-IDS-Bench 是什么?
日本 ONESTRUCTION 与 AWS Generative AI Innovation Center 合作的研究成果:评估 AI 能否把 BIM 信息要求(自然语言需求)转换成 IDS 的评测基准,论文获 CIKM 2026 Resource Track 收录。
2. 这个基准的题库规模有多大?
6 名 BIM 与 IDS 专家编写 83 个实务场景,形成日语和英语双语共 166 个示例,并配套参考 IDS 文件。
3. 评测是怎么进行的?
分两个阶段:第一阶段用 buildingSMART 的 IDS Audit Tool 检查规范格式符合性;第二阶段把生成内容与专家参考答案逐项比对查内容。
4. 10 种大模型的实测成绩如何?
最高 F1 为 65.6%,最高内容检查通过率为 33.1%,两项分属不同评价维度。格式过关不等于内容靠谱,实际交付仍需人工复核。
5. AI 写 IDS 现在能直接用于项目交付吗?
还不能。现阶段更适合作为”初稿助手”,生成草稿后必须由懂 BIM、IFC 词汇及验证规则的人员逐项复核,并用工具做格式校验,才能用于实际交付。
想系统学习 BIM 与 IDS 相关知识、下载更多实务资料的读者,可以到 BIM资源网看看站内丰富的资源,每天都有更新,下载走专属网盘速度也快。了解 BIM资源网 VIP 会员


评论0